标签 javascript 下的文章

关于如何去除一个给定数组中的重复项,应该是 Javascript 面试中最常见的一个问题了,最常见的方式有三种:Set、Array.prototype.filter 以及 Array.prototype.reduce,对于只有简单数据的数组来讲,我最喜欢 Set,没别的,就是写起来简单。

const originalArray = [1, 2, '咩', 1, 'Super Ball', '咩', '咩', 'Super Ball', 4]

const bySet = [...new Set(originalArray)]

const byFilter = originalArray.filter((item, index) => originalArray.indexOf(item) === index)

const byReduce = originalArray.reduce((unique, item) => unique.includes(item) ? unique : [...unique, item], [])

使用 Set

先让我们来看看 Set 到底是个啥

Set 对象允许你存储任何类型的唯一值,无论是原始值或者是对象引用。

https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Reference/Global_Objects/Set

  • 首先,Set 中只允许出现唯一值
  • 唯一性是比对原始值或者对象引用

const bySet = [...new Set(originalArray)] 这一段的操作,我们将它拆分来看:

const originalArray = [1, 2, '咩', 1, 'Super Ball', '咩', '咩', 'Super Ball', 4]

const uniqueSet = new Set(originalArray)
// 得到 Set(5) [ 1, 2, "咩", "Super Ball", 4 ]

const bySet = [...uniqueSet]
// 得到 Array(5) [ 1, 2, "咩", "Super Ball", 4 ]

在将 Set 转为 Array 时,也可以使用 Array.from(set)。

使用 Array.prototype.filter

要理解 filter 方法为什么可以去重,需要关注一下另一个方法 indexOf

indexOf()方法返回在数组中可以找到一个给定元素的第一个索引,如果不存在,则返回 -1。

https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Reference/Global_Objects/Array/indexOf

const beasts = ['ant', 'bison', 'camel', 'duck', 'bison'];

console.log(beasts.indexOf('bison'));
// expected output: 1

// start from index 2
console.log(beasts.indexOf('bison', 2));
// expected output: 4

console.log(beasts.indexOf('giraffe'));
// expected output: -1

filter() 方法创建一个新数组, 其包含通过所提供函数实现的测试的所有元素。

https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Reference/Global_Objects/Array/filter

filter 方法接受两个参数:

  • 第一个参数:一个回调函数, filter 会将数据中的每一项都传递给该函数,若该函数返回 真值,则数据保存,返回 假值,则数据将不会出现在新生成的数据中
  • 第二个参数:回调函数中 this 的指向

我们将上面的去重方法按下面这样重写一下,就可以看清整个 filter 的执行过程了。

const originalArray = [1, 2, '咩', 1, 'Super Ball', '咩', '咩', 'Super Ball', 4]

const table = []

const byFilter = originalArray.filter((item, index) => {
  // 如果找到的索引与当前索引一致,则保留该值
  const shouldKeep = originalArray.indexOf(item) === index
  table.push({
    序号: index,
    值: item,
    是否应该保留: shouldKeep ? '保留' : '删除'
  })
  return shouldKeep
})

console.log(byFilter)
console.table(table)

-|-|-|-
序号|值|是否应该保留|-
0|1|保留|第一次出现
1|2|保留|第一次出现
2|咩|保存|第一次出现
3|1|删除|第二次出现
4|Super Ball|保留|第一次出现
5|咩|删除|第二次出现
6|咩|删除|第三次出现
7|Super Ball|删除|第二次出现
8|4|保留|第一次出现

使用 Array.prototype.reduce

reduce() 方法对数组中的每个元素执行一个由您提供的 reducer 函数(升序执行),将其结果汇总为单个返回值。

https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Reference/Global_Objects/Array/Reduce

Array.prototype.reduce 方法接受两个参数:

  • Callback:回调函数,它可以接收四个参数

    • Accumulator:累计器,这个其实是让很多人忽略的一点,就是,累计器其实可以是任何类型的数据
    • Current Value:当前值
    • Current Index:当前值的索引
    • Source Array:源数组
  • Initial Value:累计器的初始值,就跟累计器一样,这个参数也总是被绝大多数人忽略

就像 filter 章节一样,我们来看看 reduce 的执行过程:

const originalArray = [1, 2, '咩', 1, 'Super Ball', '咩', '咩', 'Super Ball', 4]

const byReduce = originalArray.reduce((unique, item, index, source) => {
  const exist = unique.includes(item)
  const next = unique.includes(item) ? unique : [...unique, item]
  console.group(`遍历第 ${index} 个值`)
  console.log('当前累计器:', unique)
  console.log('当前值:', item)
  console.log('是否已添加进累计器?', exist)
  console.log('新值', next)
  console.groupEnd()
  return next
}, [])

先来回答一下下面这个问题:对于 setTimeout(function() { console.log('timeout') }, 1000) 这一行代码,你从哪里可以找到 setTimeout 的源代码(同样的问题还会是你从哪里可以看到 setInterval 的源代码)?

很多时候,可以我们脑子里面闪过的第一个答案肯定是 V8 引擎或者其它 VM们,但是要知道的一点是,所有我们所见过的 Javascript 计时函数,都没有出现在 ECMAScript 标准中,也没有被任何 Javascript 引擎实现,计时函数,其实都是由浏览器(或者其它运行时,比如 Node.js)实现的,并且,在不同的运行时下,其表现形式有可能都不一致。

在浏览器中,主计时器函数是 Window 接口的一部分,这保证了包括如 setTimeout、setInterval 等计时器函数以及其它函数和对象能被全局访问,这才是你可以随时随地使用 setTimeout 的原因。同样的,在 Node.js 中,setTimeout 是 global 对象的一部分,这拿得你也可以像在浏览器里面一样,随时随地的使用它。

到现在可能会有一些人感觉这个问题其实并没有实际的价值,但是作为一个 Javascript 开发者,如果不知道本质,那么就有可能不能完全的理解 V8 (或者其它VM)是到底是如何与浏览器或者 Node.js 相互作用的。

暂缓一个函数的执行

计时器函数都是更高阶的函数,它们可以用于暂缓一个函数的执行,或者让一个函数重复执行(由他们的第一个参数执行需要执行的函数)。

下面这是一个暂缓执行的示例:

setTimeout(() => {
  console.log('距离函数的调用,已经过去 4 秒了')
}, 4 * 1000)

在上面的示例中, setTimeout 将 console.log 的执行暂缓了 4 * 1000 毫秒,也就是 4 秒钟, setTimeout 的第一个函数,就是需要暂缓执行的函数,它是一个函数的引用,下面这个示例是我们更加常见到的写法:

const fn = () => {
  console.log('距离函数的调用,已经过去 4 秒了')
}

setTimeout(fn, 4 * 1000)

传递参数

如果被 setTimeout 暂缓的函数需要接收参数,我们可以从第三个参数开始添加需要传递给被暂缓函数的参数:

const fn = (name, gender) => {
  console.log(`I'm ${name}, I'm a ${gender}`)
}

setTimeout(fn, 4 * 1000, 'Tao Pan', 'male')

上面的 setTimeout 调用,其结果与下面这样调用类似:

setTimeout(() => {
  fn('Tao Pan', 'male')
}, 4 * 1000)

但是记住,只是结果类似,本质上是不一样的,我们可以用伪代码来表示 setTimeout 的函数实现:

const setTimeout = (fn, delay, ...args) => {
  wait(delay) // 这里表示等待 delay 指定的毫秒数
  fn(...args)
}

挑战一下

编写一个函数:

  • 当 delay 为 4 秒的时候,打印出:距离函数的调用,已经过去 4 秒了
  • 当 delay 为 8 秒的时候,打印出:距离函数的调用,已经过去 8 秒了
  • 当 delay 为 N 秒的时候,打印出:距离函数的调用,已经过去 N 秒了

下面这个是我的一个实现:

const delayLog = delay => {
  setTimeout(console.log, delay * 1000, `距离函数的调用,已经过去 ${delay} 秒了`)
}

delayLog(4) // 输出:距离函数的调用,已经过去 4 秒了
delayLog(8) // 输出:距离函数的调用,已经过去 8 秒了

我们来理一下 delayLog(4) 的整个执行过程:

  1. delay = 4
  2. setTimeout 执行
  3. 4 * 1000 毫秒后, setTimeout 调用 console.log 方法
  4. setTimeout 计算其第三个参数 距离函数的调用,已经过去 ${delay} 秒了 得到 距离函数的调用,已经过去 4 秒了
  5. setTimeout 将计算得到的字符串当作 console.log 的第一个参数
  6. console.log('距离函数的调用,已经过去 4 秒了') 执行,输出结果

规律性重复一个函数的执行以及停止重复调用

如果我们现在要每 4 秒第印一次呢?这里面就有很多种实现方式了,假如我们还是使用 setTimeout 来实现,我们可以这样做:

const loopMessage = delay => {
  setTimeout(() => {
    console.log('这里是由 loopMessage 打印出来的消息')
    loopMessage(delay)
  }, delay * 1000)
}

loopMessage(1) // 此时,每过 1 秒钟,就会打印出一段消息:*这里是由 loopMessage 打印出来的消息*

但是这样有一个问题,就是开始之后,我们就没有办法停止,怎么办?可以稍稍改改实现:

let loopMessageTimer

const loopMessage = delay => {
  loopMessageTimer = setTimeout(() => {
    console.log('这里是由 loopMessage 打印出来的消息')
    loopMessage(delay)
  }, delay * 1000)
}

loopMessage(1)

clearTimeout(loopMessageTimer) // 我们随时都可以使用 `clearTimeout` 清除这个循环

但是这样还是有问题的,如果 loopMessage 被调用多次,那么他们将共用一个 loopMessageTimer,清除一个,将清除所有,这是肯定不行的,所以,还得再改造一下:

const loopMessage = delay => {
  let timer
  
  const log = () => {
    timer = setTimeout(() => {
      console.log(`每 ${delay} 秒打印一次`)
      log()
    }, delay * 1000)
  }

  log()

  return () => clearTimeout(timer)
}

const clearLoopMessage = loopMessage(1)
const clearLoopMessage2 = loopMessage(1.5)

clearLoopMessage() // 我们在任何时候都可以取消任何一个重复调用,而不影响其它的

这…… 实现是实现了,但是其它有更好的解决办法:

const timer = setInterval(console.log, 1000, '每 1 秒钟打印一次')

clearInterval(timer) // 随时可以 `clearInterval` 清除

更加深入了认识取消计时器(Cancel Timers)

上面的示例只是简单的给我们展现了 setTimeout 以及 setInterval,也看到了,我们可以通过 clearTimeout 或者 clearInterval 取消计时器,但是关于计时器,远远不止这点知识,请看下面的代码(请):

const cancelImmediate = () => {
  const timerId = setTimeout(console.log, 0, '暂缓了 0 秒执行')
  clearTimeout(timerId)
}

cancelImmediate() // 这里并不会有任何输出

或者看下面这样的代码:

const cancelImmediate2 = () => setTimeout(console.log, 0, '暂缓了 0 秒执行')

const timerId = cancelImmediate2()

clearTimeout(timerId)

请将上面的的任一代码片段同时复制到浏览器的控制台中(有多行复制多行)执行,你会发现,两个代码片段都没有任何输出,这是为什么?

这是因为,Javascript 的运行机制导致,任何时刻都只能存在一个任务在进行,虽然我们调用的是暂缓 0 秒,但是,由于当前的任务还没有执行完成,所以,setTimeout 中被暂缓的函数即使时间到了也不会被执行,必须等到当前的任务完全执行完成,那么,再试着,上面的代码分行复制到控制台,看看结果是不是会打印出 暂缓了 0 秒执行 了?答案是肯定的。

当你一行一行复制执行的时候, cancelImmediate2 执行完成之后,当前任务就已经全部执行完成了,所以开始执行下一个任务(console.log 开始执行)。

从上面的示例中,我们可以看出,setTimeout 其实是将一个任务安排进一个 Javascript 的任务队列里面去,当前面的所有任务都执行完成之后,如果这个任务时间到了,那么就立即执行,否则,继续等待计时结束。

此时,你应该发现,只要是 setTimeout 所暂缓的函数没有被执行(任务还没有完成),那么,我们就可以随时使用 clearTimeout 清除掉这个暂缓(将这条任务从队列里面移除)

计时器是没有任何保证的

通过前面的例子,我们知道了 setTimeout 的 delay 为 0 时,并不表示立马就会执行了,它必须等到所有的当前任务(对于一个 JS 文件来讲,就是需要执行完当前脚本中的所有调用)执行完成之后都会执行,而这里面就包括我们调用的 clearTimeout。

下面用一个示例来更清楚了说明这个问题:

setTimeout(console.log, 1000, '1 秒后执行的')

// 开始时间
const startTime = new Date()
// 距离开始时间已经过去几秒
let secondsPassed = 0
while (true) {
  // 距离开始时间的毫秒数
  const duration = new Date() - startTime
  // 如果距离开始时间超过 5000 毫秒了, 则终止循环
  if (duration > 5000) {
    break
  } else {
    // 如果距离开始时间增长一秒,更新 secondsPassed
    if (Math.floor(duration / 1000) > secondsPassed) {
      secondsPassed = Math.floor(duration / 1000)
      console.log(`已经过去 ${secondsPassed} 秒了。`)
    }
  }
}

你们猜上面这段代码会有什么样的输出?是下面这样的吗?

1 秒后执行的
已经过去 1 秒了。
已经过去 2 秒了。
已经过去 3 秒了。
已经过去 4 秒了。
已经过去 5 秒了。

并不是这样的,而是下面这样的:

已经过去 1 秒了。
已经过去 2 秒了。
已经过去 3 秒了。
已经过去 4 秒了。
已经过去 5 秒了。
1 秒后执行的

怎么会这样?这是因为 while(true) 这个循环必须要执行超过 5 秒钟的时间之后,才算当前所有任务完成,在它 break 之前,其它所有的操作都是没有用的,当然,我们不会在开发的过程中去写这样的代码,但是并不表示就不存在这样的情况,想象以下下面这样的场景:

setTimeout(somethingMustDoAfter1Seconds, 1000)

openFileSync('file more then 1gb')

这里面的 openFileSync 只是一个伪代码,它表示我们需要同步进行一个特别费时的操作,这个操作很有可能会超过 1 秒,甚至更长的时间,但是上面那个 somethingMustDoAfter1Seconds 将一直处于挂起状态,只要这个操作完成,它才有可能执行,为什么叫有可能?那是因为,有可能还有别的任务又会占用资源。所以,我们可以将 setTimeout 理解为:计时结束是执行任务的必要条件,但是不是任务是否执行的决定性因素。

setTimeout(somethingMustDoAfter1Seconds, 1000) 的意思是,必须超过 1000 毫秒后,somethingMustDoAfter1Seconds 才允许执行。

再来一个小挑战

那如果我需要每一秒钟都打印一句话怎么办?从上面的示例中,已经很明显的看到了,setTimeout 是肯定解决不了这个问题了,不信我们可以试试下面这个代码片段:

const log = (delay) => {
  timer = setTimeout(() => {
    console.log(`每 ${delay} 秒打印一次`)
    log(delay)
  }, delay * 1000)
}

log(1)

上面的代码是没有任何问题的,在浏览器的控制台观察,你会发现确实每一秒钟都打印了一行,但是再试试下面这样的代码:

const log = (delay) => {
  timer = setTimeout(() => {
    console.log(`每 ${delay} 秒打印一次`)
    log(delay)
  }, delay * 1000)
}

const readLargeFileSync = () => {
  // 开始时间
  const startTime = new Date()
  // 距离开始时间已经过去几秒
  let secondsPassed = 0
  while (true) {
    // 距离开始时间的毫秒数
    const duration = new Date() - startTime
    // 如果距离开始时间超过 5000 毫秒了, 则终止循环
    if (duration > 5000) {
      break
    } else {
      // 如果距离开始时间增长一秒,更新 secondsPassed
      if (Math.floor(duration / 1000) > secondsPassed) {
        secondsPassed = Math.floor(duration / 1000)
        console.log(`已经过去 ${secondsPassed} 秒了。`)
      }
    }
  }
}

log(1)

setTimeout(readLargeFileSync, 1300)

输出结果是:

每 1 秒打印一次
已经过去 1 秒了。
已经过去 2 秒了。
已经过去 3 秒了。
已经过去 4 秒了。
已经过去 5 秒了。
每 1 秒打印一次
  1. 第一秒的时候, log 执行
  2. 第 1300 毫秒时,开始执行 readLargeFileSync 这会需要整整 5 秒钟的时间
  3. 第 2 秒的时候,log 执行时间到了,但是当前任务并没有完成,所以,它不会打印
  4. 第 5 秒的时候, readLargeFileSync 执行完成了,所以 log 继续执行
关于这个具体怎么实现,就不在本文讨论了

最终,到底是谁在调用那个被暂缓的函数?

当我们在一个 function 中调用 this 时,this 关键字会指向当前函数的 caller:

function whoCallsMe() {
  console.log('My caller is: ', this)
}

当我们在浏览器的控制台中调用 whoCallsMe 时,会打印出 Window,当在 Node.js 的 REPL 中执行时,会执行出 global,如果我们将 whoCallsMe 设置为一个对象的属性:

function whoCallsMe() {
  console.log('My caller is: ', this)
}

const person = {
  name: 'Tao Pan',
  whoCallsMe
}

person.whoCallsMe()

这会打印出:My caller is: Object { name: "Tao Pan", whoCallsMe: whoCallsMe() }

那么?

function whoCallsMe() {
  console.log('My caller is: ', this)
}

const person = {
  name: 'Tao Pan',
  whoCallsMe
}

setTimeout(person.whoCallsMe, 0)

这会打印出什么?这个很容易被忽视的问题,其实真的值得我们去思考。

请直接将上面这个代码片段复制进浏览器的控制台,看执行的结果:

My caller is:  Window https://pub.ofcrab.com/admin/write-post.php?cid=2952

再打开系统终端,进入 Node.js REPL 中,执行同样的代码,看执行结果:

My caller is:  Timeout {
  _idleTimeout: 1,
  _idlePrev: null,
  _idleNext: null,
  _idleStart: 7052,
  _onTimeout: [Function: whoCallsMe],
  _timerArgs: undefined,
  _repeat: null,
  _destroyed: false,
  [Symbol(refed)]: true,
  [Symbol(asyncId)]: 221,
  [Symbol(triggerId)]: 5
}

回到这句话:当我们在一个 function 中调用 this 时,this 关键字会指向当前函数的 caller,当我们使用 setTimeout 时,这个 caller 是跟当前的运行时有关系的,如果我想 this 总是指向 person 对象呢?

function whoCallsMe() {
  console.log('My caller is: ', this)
}

const person = {
  name: 'Tao Pan'
}
person.whoCallsMe = whoCallsMe.bind(person)

setTimeout(person.whoCallsMe, 0)

结语

标题是写上了 你需要知道的一切都在这里,但是如果有什么没有考虑到了,欢迎大家指出。
本文列举了一些日常会使用到的 Javascript技巧,可以明显提升代码的表现力。

解构赋值

首先,我们来看一下下面这段代码:

const animal = {
  type: {
    mammal: {
      bear: {
        age: 12
      },
      deer: {
        age: 4
      }
    }
  }
}

console.log(animal.type.mammal.bear) // 输出:{ age: 12 }
console.log(animal.type.mammal.deer) // 输出:{ age: 4 }

对象解构赋值

其实我们可以利用解构赋值做得更好:

const animal = {
  type: {
    mammal: {
      bear: {
        age: 12
      },
      deer: {
        age: 4
      }
    }
  }
}

const { bear, deer } = animal.type.mammal
console.log(bear) // 输出:{ age: 12 }
console.log(deer) // 输出:{ age: 4 }

不管上面哪种实现方式,我们都使用的 const,这表示这些被定义的变量不允许再被赋值,我们推荐 在编写 Javascript 代码时,尽可能的使用 const,除非这个变量确实需要被多次赋值,比如,年龄是可以增长的:

const animal = {
  type: {
    mammal: {
      bear: {
        age: 12
      },
      deer: {
        age: 4
      }
    }
  }
}

const { age } = animal.type.mammal.bear

age += 1 // 这里会报错,因为 age 是一个 const 变量

在这种情况下,我们可以将 const 改为 let:

const animal = {
  type: {
    mammal: {
      bear: {
        age: 12
      },
      deer: {
        age: 4
      }
    }
  }
}

let { age } = animal.type.mammal.bear

age += 1
console.log(age) // 输出:13

接下来,我们给每一个 animal 增加一个姓名字段 name,然后,同时使用 let 与 const,任何动物年龄是会增长的,但是姓名不允许修改:

const animal = {
  type: {
    mammal: {
      bear: {
        name: 'Bug',
        age: 12
      },
      deer: {
        name: 'Debug',
        age: 4
      }
    }
  }
}

const { name } = animal.type.mammal.bear
let { age } = animal.type.mammal.bear

age += 1
console.log(age) // 输出:13
console.log(name) // 输出:Bug

数组解构赋值

我们现在有三只动物,有一个数组保存了它们的名字:

const animalNames = ['Bug', 'Debug', 'Bugfix']
const [bug, debug, bugfix] = animalNames
console.log(debug) // 输出:Debug

解构赋值时重命名

我们还有可能有这样的需求,我想同时拿到上面示例中 animal 那个对象中,两只动物的姓名,这个时候我们可以完全按照对象的结构去解构它:

const animal = {
  type: {
    mammal: {
      bear: {
        name: 'Bug',
        age: 12
      },
      deer: {
        name: 'Debug',
        age: 4
      }
    }
  }
}

const { bear: { name }, deer: { name }} = animal.type.mammal

上面的意思是:从 animal.type.mammal 对象中,访问 bear,并拿到它的 name 的值,并赋值给一个 const 变量,变量名为 name,同时再从 deer 中拿到 name 的值,赋值给一个名为 name 的 const 变量。

看出问题来了吧? name 被声明了两次,这是不允许的,此时,我们可以在声明时,为两个 name 指定不同的名称:

const animal = {
  type: {
    mammal: {
      bear: {
        name: 'Bug',
        age: 12
      },
      deer: {
        name: 'Debug',
        age: 4
      }
    }
  }
}

const { bear: { name: bearName }, deer: { name: deerName }} = animal.type.mammal
console.log(bearName) // 输出:Bug
console.log(deerName) // 输出:Debug
数组的解构中同样支持重命名。

箭头函数

箭头函数可以大大减少编码工作量,但是它们并非普通函数的完全替代者,先来看看下面的代码:

const animals = ['Bug', 'Debug', 'Bugfix']

animals.forEach(function (animal) {
  console.log(animal)
})

我们使用箭头函数改写上面的代码:

const animals = ['Bug', 'Debug', 'Bugfix']

animals.forEach(animal => {
  console.log(animal)
})

这是一个简单的示例,只是为了证明箭头函数能让我们的代码更清晰可读,编码量也能大大减少,有一个不成文的经验是,一个项目的代码量越少,维护的成本一般情况下,都会越低,那为了证明箭头函数确实有用,我们再来看一个更复杂点的例子:

function multiplyAndAdd(multiply) {
  const pow = multiply ** multiply
  return function (number) {
    return pow + number
  }
}

const result = multipleAndAdd(3)(5) // 等于:3 ** 3 + 5 = 27 + 5 = 32

console.log(result) // 输出:32

用箭头函数再来改写一次:

const multiplyAndAdd = multiply => {
  const pow = multiply ** multiply
  return number => pow + number
}

如果熟练的话,我一般会这么写:

const multiplyAndAdd = multiply => number => multiply ** multiply + number

这里面可以这么阅读:

  • 声明一个 const 值:multiplyAndAdd,它的值为 multiply => number => multiply ** multiply + number,这个都很好理解
  • 这个值是一个箭头函数,该函数接受一个名为 multiply 的参数,返回 number => multiply ** multiply + number
  • 它的返回值还是一个箭头函数,这个箭头函数接受一个 number 参数,返回 multiply ** multiply + number
这么写可能会提升阅读难度,但是确实能节省代码量,但是个人还是不太推荐在多人协作的项目里面大量使用这样的写法。

Javascript 总是以超自然的方式执行我们的代码,这是一件很神奇的事情,如果不信的话,思考一下 ['1', '7', '11'].map(parseInt) 的结果是什么?你以为会是 [1, 7, 11] 吗?我都这么问了,那肯定不是:

['1', '7', '11'].map(parseInt)
// 输出:(3) [1, NaN, 3]

要理解为什么为会这里,首先需要了解一些 Javascript 概念,如果你是一个不太喜欢阅读长文的人,那直接跳到最后看结论吧

真值与假值

请看下面示例:

if (true) {
  // 这里将启动都会被执行
} else {
  // 这里永远都不会被执行
}

在上面的示例中, if-else 声明为 true,所以 if-block 会一直都执行,而 else-block 永远都会被忽略掉,这是个很容易理解的示例,下面我们来看看另一个例子:

if ("hello world") {
  // 这里会被执行吗?
  console.log("条件判断为真");
} else {
  // 或者会执行这里吗?
  console.log("条件判断为假");
}

打开你的开发者工具 console 面板,执行上面的代码,你会得到看到会打印出 条件判断为真,也就是说 "hello world" 这一个字符串被认为是真值。

在 JavaScript 中,truthy(真值)指的是在布尔值上下文中,转换后的值为真的值。所有值都是真值,除非它们被定义为 假值(即除 false、0、""、null、undefined 和 NaN 以外皆为真值)。

引用自:Mozilla Developer: Truthy(真值)

这里一定要划重点:在布尔上下文中,除 false、0、""(空字符串)、null、undefined 以及 NaN 外,其它所有值都为真值

基数

0 1 2 3 4 5 6 7 8 9 10

当我们从 0 数到 9,每一个数字的表示符号都是不一样的(0-9),但是当我们数到 10 的时候,我们就需要两个不同的符号 1 与 0 来表示这个值,这是因为,我们的数学计数系统是一个十进制的。

基数,是一个进制系统下,能使用仅仅超过一个符号表示的数字的最小值,不同的计数进制有不同的基数,所以,同一个数字在不同的计数体系下,表示的真实数据可能并不一样,我们来看一下下面这张在十进制、二进制以及十六进制不同值在具体表示方法:

-|-|-
十进制(基数:10)|二进制(基数:2)|十六进制(基数:16)
-|-|-
0 | 0 | 0
1 | 1 | 1
2 | 10 | 2
3 | 11 | 3
4 | 100 | 4
5 | 101 | 5
6 | 110 | 6
7 | 111 | 7
8 | 1000 | 8
9 | 1001 | 9
10 | 1010 | A
11 | 1011 | B
12 | 1100 | C
13 | 1101 | D
14 | 1110 | E
15 | 1111 | F
16 | 10000 | 10
17 | 10001 | 11
18 | 10002 | 12

你应该已经注意到了, 11 在上表中,总共出现了三次。

函数的参数

在 Javascript 中,一个函数可以传递任何多个数量的参数,即使调用时传递的数量与定义时的数量不一致。缺失的参数会以 undefined 作为实际值传递给函数体,然后多余的参数会直接被忽略掉(但是你还是可以在函数体内通过一个类数组对象 arguments 访问到)。

function sum(a, b) {
  console.log(a);
  console.log(b);
}

sum(1, 2);    // 输出:1, 2
sum(1);       // 输出:1, undefined
sum(1, 2, 3); // 输出:1, 2

map()

快要有结果了。

map() 是一个存在于数组原型链上的方法,它将其数组实例中的每一个元素,传递给它的第一个参数(在本文最开始的例子中就是 parseInt),然后将每一个返回值都保存到同一个新的数组中,遍历完所有元素之后,将新的包含了所有结果的数组返回。

function multiplyBy3 (number) {
  return number * 3;
}

const result = [1, 2, 3, 4, 5].map(multiplyBy3);

console.log(result); // 输出:[3, 6, 9, 12, 15]

现在,假想一下,我们想使用 map() 将一个数组中的每一个元素都打印到控制台,我可以直接将 console.log 函数传递给 map() 方法:

[1, 2, 3, 4, 5].map(console.log);

输出:

1 0 (5) [1, 2, 3, 4, 5]
2 1 (5) [1, 2, 3, 4, 5]
3 2 (5) [1, 2, 3, 4, 5]
4 3 (5) [1, 2, 3, 4, 5]
5 4 (5) [1, 2, 3, 4, 5]

是不是感觉有点神奇了?为什么会这样?来分析一下上面输出的内容都有些什么?

  • 第一列:这个看上去跟我们想要的输出是一致的
  • 第二列:这个是一个从 0 开始递增的数字
  • 第三列:总是 (5) [1, 2, 3, 4, 5]

再来看看下面这段代码:

[1, 2, 3, 4, 5].map((value, index, array) => console.log(value, index, array));

在控制台上试试执行上面这行代码,你会发现,它与 [1, 2, 3, 4, 5].map(console.log); 输出的结果是完全一致的,**总是会被我们忽略的一点是,map() 方法会将三个参数传递传递给它的函数,分别是 currentValue(当前值)、currentIndex(当前索引)以及 array 本身,这就是,上面为什么结果有三列的原因,如果我们只是想将每一个值打印,那么需要像下面这样写:

[1, 2, 3, 4, 5].map((value) => console.log(value));

回到最开始的问题

现在让我们来回顾一下本文最开始的问题:

为什么 ['1', '7', '11'].map(parseInt) 的结果是 [1, NaN, 3]?

来看看 parseInt() 是一个什么样的函数:

parseInt(string, radix)将一个字符串 string 转换为 radix 进制的整数, radix 为介于 2-36 之间的数。

详情:https://developer.mozilla.org/zh-CN/docs/Web/JavaScript/Reference/Global_Objects/parseInt

这里还有一条需要注意的是,虽然我们一般都是使用 parseInt('11') 这样的调用方式,认为是将 11 按十进制转换成数字,但是,请在使用的时候,永远都添加 radix 参数,因为, radix 为 10 并不保证永远有效(这并不是规范的一部分)。

那么看看下面这些的输出:

parseInt('11');             // 输出:11
parseInt('11', 2);          // 输出:3
parseInt('11', 16);         // 输出:17

parseInt('11', undefined);  // 输出:11 (radix 是假值)
parseInt('11', 0);          // 输出:11 (radix 是假值)

现在,让我们一步一步来看 ['1', '7', '11'].map(parseInt) 的整个执行过程,首先,我们可以将这一行代码,转换为完整的版本:

['1', '7', '11'].map((value, index, array) => parseInt(value, index, array))

根据前面的知识,我们应该知道, parseInt(value, index, array) 中的 array 会被忽略(并放入 arguments 对象中。

那么,完整的代码就是下面这样的:

['1', '7', '11'].map((value, index, array) => parseInt(value, index))
  • 遍历到第一个元素时:

    parseInt('1', 0);

    radix 为 0,是一个假值,在我们的控制台中,一般将使用 10 进制,所有,得到结果 1

  • 遍历到第二个元素时:

    parseInt('7', 1)

    在一个 1 进制系统中,7 是不存在的,所以得到结果 NaN(不是一个数字)

  • 遍历到第三个元素时:

    parseInt('11', 2)

    在一个 2 进制系统中,11 就是进十制的 3

总结

['1', '7', '11'].map(parseInt) 的结果是 [1, NaN, 3] 的原因是因为,map() 方法是向传递给他的函数中传递三个参数,分别为当前值,当前索引以及整个数组,而 parseInt 函数接收两个参数:需要转换的字符串,以及进制基数,所以,整个语句可以写作:['1', '7', '11'].map((value, index, array) => parseInt(value, index, array)),array 被 parseInt 舍弃之后,得到的结果分别是:parseInt('1', 0)、parseInt('7', 1) 以及 parseInt('11', 2),也就是上面看到的 [1, NaN, 3]。

正确的写法应该是:

['1', '7', '11'].map(numStr => parseInt(numStr, 10));

命名规则

避免使用一个字母命名

eslint

// bad
function q() {
  // ...
}

// good
function query() {
  // ...
}

使用小驼峰式命名对象、函数、实例

eslint

// bad
const OBJEcttsssss = {};
const this_is_my_object = {};
function c() {}

// good
const thisIsMyObject = {};
function thisIsMyFunction() {}

使用大驼峰式命名类

eslint

// bad
function user(options) {
  this.name = options.name;
}

const bad = new user({
  name: 'nope',
});

// good
class User {
  constructor(options) {
    this.name = options.name;
  }
}

const good = new User({
  name: 'yup',
});

不要使用前置或后置下划线(除非引入的第三方库本身使用)

eslint

JavaScript 没有私有属性或私有方法的概念。尽管前置下划线通常的概念上意味着“private”,事实上,这些属性是完全公有的,因此这部分也是你的API的内容。这一概念可能会导致开发者误以为更改这个不会导致崩溃或者不需要测试。 如果你想要什么东西变成“private”,那就不要让它在这里出现。
// bad
this.__firstName__ = 'Panda';
this.firstName_ = 'Panda';
this._firstName = 'Panda';

// good
this.firstName = 'Panda';

不要保存引用 this

用箭头函数或函数绑定——Function#bind

// bad
function foo() {
  const self = this;
  return function () {
    console.log(self);
  };
}

// bad
function foo() {
  const that = this;
  return function () {
    console.log(that);
  };
}

// good
function foo() {
  return () => {
    console.log(this);
  };
}

保证文件名、export 模块名以及 import 模块名一致

// file 1 contents
class CheckBox {
  // ...
}
export default CheckBox;

// file 2 contents
export default function fortyTwo() { return 42; }

// file 3 contents
export default function insideDirectory() {}

// in some other file
// bad
import CheckBox from './checkBox'; // PascalCase import/export, camelCase filename
import FortyTwo from './FortyTwo'; // PascalCase import/filename, camelCase export
import InsideDirectory from './InsideDirectory'; // PascalCase import/filename, camelCase export

// bad
import CheckBox from './check_box'; // PascalCase import/export, snake_case filename
import forty_two from './forty_two'; // snake_case import/filename, camelCase export
import inside_directory from './inside_directory'; // snake_case import, camelCase export
import index from './inside_directory/index'; // requiring the index file explicitly
import insideDirectory from './insideDirectory/index'; // requiring the index file explicitly

// good
import CheckBox from './CheckBox'; // PascalCase export/import/filename
import fortyTwo from './fortyTwo'; // camelCase export/import/filename
import insideDirectory from './insideDirectory'; // camelCase export/import/directory name/implicit "index"
// ^ supports both insideDirectory.js and insideDirectory/index.js

export default 一个函数时、函数名小驼峰式,文件与函数名一致

function makeStyleGuide() {
  // ...
}

export default makeStyleGuide;

当 export 一个结构体、类、单例、函数库或者对象时,使用大驼峰式

const Helpers = {
  guid: () => return uuid(),
};

export default Helpers;

简称或缩写应该全部大写或者全部小写

名字是给人读的,不是为了适应电脑的算法
// bad
import SmsContainer from './containers/SmsContainer';

// bad
const HttpRequests = [
  // ...
];

// good
import SMSContainer from './containers/SMSContainer';

// good
const HTTPRequests = [
  // ...
];

// best
import TextMessageContainer from './containers/TextMessageContainer';

// best
const Requests = [
  // ...
];

使用全大写字母设置静态变量

  1. 导出变量
  2. 是 const 定义的, 保证不能被改变
  3. 这个变量是可信的,他的子属性都是不能被改变的

一般我们都将项目的全局参数使用这种 全大写+下划线分隔的常量 来定义一些系统配置参数导出,比如 const LIST_VIEW_PAGE_SIZE = 10 可以表示列表页每次加载10条数据;

如果导出项目是一个对象,那么必须保证这个对象的所有属性都是不可变的,同时,它的属性不再是全大写,而是使用小写驼峰式。

// bad
const PRIVATE_VARIABLE = 'should not be unnecessarily uppercased within a file';

// bad
export const THING_TO_BE_CHANGED = 'should obviously not be uppercased';

// bad
export let REASSIGNABLE_VARIABLE = 'do not use let with uppercase variables';

// ---

// allowed but does not supply semantic value
export const apiKey = 'SOMEKEY';

// better in most cases
export const API_KEY = 'SOMEKEY';

// ---

// bad - unnecessarily uppercases key while adding no semantic value
export const MAPPING = {
  KEY: 'value'
};

// good
export const MAPPING = {
  key: 'value'
};

访问器

若非必要,不要使用访问器

由于 JavaScript 的 getters/setters 是有副作用的,而且会让他人在查看代码的时候难以理解,后期也会难以维护,所以不推荐使用访问器函数,如果非要使用,可以使用自己实现的 getVal() 与 setVal()。

// bad
class Dragon {
  get age() {
    // ...
  }

  set age(value) {
    // ...
  }
}

// good
class Dragon {
  getAge() {
    // ...
  }

  setAge(value) {
    // ...
  }
}

如果属性或者方法是一个布尔判断值,那么使用 isVal() 或者 hasVal()。

// bad
if (!dragon.age()) {
  return false;
}

// good
if (!dragon.hasAge()) {
  return false;
}

如果非要使用 get() 与 set(),那么它们两者必须同时使用

class Jedi {
  constructor(options = {}) {
    const lightsaber = options.lightsaber || 'blue';
    this.set('lightsaber', lightsaber);
  }

  set(key, val) {
    this[key] = val;
  }

  get(key) {
    return this[key];
  }
}

事件

当你需要向事件附加数据时,将数据封装成为一个对象,而不是使用原始值,这会使得以后可以很方便的增加附加值的字段。

// bad
$(this).trigger('listingUpdated', listing.id);

// ...

$(this).on('listingUpdated', (e, listingID) => {
  // do something with listingID
});

而是:

// good
$(this).trigger('listingUpdated', { listingID: listing.id });

// ...

$(this).on('listingUpdated', (e, data) => {
  // do something with data.listingID
});

jQuery

为所有 jQuery 对象加上 $ 前缀

// bad
const sidebar = $('.sidebar');

// good
const $sidebar = $('.sidebar');

// good
const $sidebarBtn = $('.sidebar-btn');

缓存 jQuery 结果

// bad
function setSidebar() {
  $('.sidebar').hide();

  // ...

  $('.sidebar').css({
    'background-color': 'pink',
  });
}

// good
function setSidebar() {
  const $sidebar = $('.sidebar');
  $sidebar.hide();

  // ...

  $sidebar.css({
    'background-color': 'pink',
  });
}

使用级联查询 $('.sidebar ul') 或者子父级查询 $('.sidebar > ul')

在 jQuery 对象查询作用域下使用 find 方法

// bad
$('ul', '.sidebar').hide();

// bad
$('.sidebar').find('ul').hide();

// good
$('.sidebar ul').hide();

// good
$('.sidebar > ul').hide();

// good
$sidebar.find('ul').hide();

ES5 兼容性

直接参考 Kangax 提供的 ES5 兼容性列表

默认参数


```
var  link  =  function(height  =  50,  color  =  'red',  url  =  'http://azat.co')  {
...
}
```

箭头函数

var fn = arg1 => arg1 * 2

多行字符串

var text = `this is
 text

模板表达式


```
var  name  =  `Your  name  is  ${first}  ${last}`
```

Promise

new Promise((resolve, reject) => {
    if (success) {
        resolve(true)
    }
    else {
        reject('error')
    }
}

块级作用的 let 和 const

let writableVariable = 1
const constantVariable = 2

类

class Obj {
    constructor (props) {
      this.props = props
    }

    log () {
        console.log(this.props)
    }
}

模块化

export const edit = () => console.log('edit')
import { edit } from './edit.js'

拆包表达式


    ```
    let obj = { name: '', slug: '' }
    let { name,: title  slug } = obj
```

改进的对象表达式

首先,一个简单的JavaScript时间线,不了解历史的人也无法创造历史。

  1. 1995年:JavaScript以LiveScript之名诞生
  2. 1997年:ECMAScript标准确立
  3. 1999年:ES3发布,IE5非常生气
  4. 2000年-2005年:XMLHttpRequest,熟知为AJAX,在如Outlook Web Access(2002)、Oddpost(2002)、Gmail(2004)、Google Maps(2005)中得到了广泛的应用
  5. 2009年:ES5发布(这是我们目前用的最多的版本),带来了forEach / Object.keys / Object.create(特地为Douglas Crockford所造,JSON标准创建者) ,还有JSON标准。

历史课上完了,我们回来讲编程。

ES6中还有很多你可能都用不上(至少现在用不上)的可圈可点的特性,以下无特定顺序:

  1. Math / Number / String / Array / Object中新的方法
  2. 二进制和八进制数据类型
  3. 自动展开多余参数
  4. For of循环(又见面了CoffeeScript)
  5. Symbols
  6. 尾部调用优化
  7. generator
  8. 更新的数据结构(如Map和Set)

如果按面向对象的思路去讲 JavaScript 的 new,还是很难去理解,我们可以从另一个方向去理解一下它。

你这些人类

我是一名程序员,也是一个人,我可能:

  • 有一个响亮亮的名称
  • 在某一天出生
  • 是个男人
  • 我能行走
  • 我还能跑步
  • 还能跳跃
  • 能说话
  • 我还能写代码

那么,在 JavaScript 中,我们可能像下面这样表达我:

const me = {
  name: '大胡子农同工潘半仙',
  birth: '1988-08-08',
  sex: 'male',
  walk: function (speed, direction, duration) {
    // 以 speed 的速度向 direction 方向行走 duration 长的时间
  },
  run: function (speed, direction, duration) {
    // 像跑步一样,速度
  },
  jump: function (high, direction, angle) {
    // 以 angle 角度向 direction 方向跳 high 高
  },
  speak: function (letters) {
    // 说出 letters 这些词
  },
  coding: function (language, line) {
    // 写程序呢
  }
}

你们这些人类

当然,这个世界上不可能只有我一个程序员,更不可能只有我一个人,就像我们这个小公司,就有七八百人,似乎所有这些人的数据都保存在数据库里面:

namesexbirth
潘韬male1988-08-08
高超male1985-08-09
春雨male1999-08-08

我们从数据库中查询出上面这几条记录,在 JavaScript 可能表示为一个二维数据,然后要创建出这三个人来,可能是下面这样的:

const people = DB.query()
// people = [['潘韬', 'male', '1988-08-08'], [...], [...]]
for (let i = 0; i < people.length; i++) {
  let [name, sex, birth] = people[i]
  people[i] = {
    name,
    sex,
    birth,
    walk: function () {},
    run: function () {},
    jump: function () {},
    speak: function () {},
    coding: function () {}
  }
}

重复的资源占用

上面大家已经发现,像上面这样去创建三个对象, walk、run、jump、speak、coding 这五件能做的事情(方法),其实做法都一样,但是我们却重复的去描述该怎么做了,其实就占用了很多资源,所以,我们可能会像下面这样改进一下:

const walk = function walk () {}
const run = function run () {}
const jump = function jump () {}
const speak = function speak () {}
const coding = function coding () {}

for (let i = 0; i < people.length; i++) {
  let [name, sex, birth] = people[i]
  people[i] = {
    name,
    sex,
    birth,
    walk,
    run,
    jump,
    speak,
    coding
  }
}

不同的人共用相同的资源(方法)

但是这个世界不止有人类

对,人类相比于这个世界上的其它生物来讲,数量根本就值得一提,如果像上面这样,可能各种不同物种能做的事情都会要定义出不同的函数,蠕动肯定不是人类会去做的事情,但很多别的生物会做,那么为了代码管理方便,我们把人能做的所有事情都放在一个对象里面,这样就相当于有了一个命名空间了,不会再跟别的物种相冲突:

const whatPeopleCanDo = {
    walk: function () {},
    run: function () {},
    jump: function () {},
    speak: function () {},
    coding: function () {}
}
for (let i = 0; i < people.length; i++) {
  let [name, sex, birth] = people[i]
  people[i] = {
    name,
    sex,
    birth,
    ...whatPeopleCanDo
  }
}

原型

但是,有的人可能我们并不知道他的 sex 信息是多少,有的也有可能不知道 birth 是多少,但是我们希望在创建这个人的时候,能给不知道的数据一些初始数据,所以, whatPeopleCanDo 并不能完全的表达出一个人,我们再改进:

const peopleLike = {
    name: '',
    sex: 'unknown',
    birth: '',
    walk: function () {},
    run: function () {},
    jump: function () {},
    speak: function () {},
    coding: function () {}
}
for (let i = 0; i < people.length; i++) {
  let [name, sex, birth] = people[i]
  people[i] = {
    ...peopleLike,
    name: name || peopleLike.name,
    sex: sex || peopleLike.sex,
    birth: birth || peopleLike.birth
  }
}

这样一来,我们就可以为不知道的属性加一些默认值,我们称 peopleLike 这个东东就为原型,它表示了像人类这样的物种有哪些属性,能干什么事情。

原型链

虽然上面已经比最开始的版本好得多了,但是还是能有很大的改进空间,我们现在像下面这样改一下:

const peoplePrototype = {
    name: '',
    sex: 'unknown',
    birth: '',
    walk: function () {},
    run: function () {},
    jump: function () {},
    speak: function () {},
    coding: function () {}
}
for (let i = 0; i < people.length; i++) {
  let [name, sex, birth] = people[i]
  people[i] = {
    name: name || peoplePrototype.name,
    sex: sex || peoplePrototype.sex,
    birth: birth || peoplePrototype.birth,
    __proto__: peoplePrototype
  }
}

我们不再把人类原型里面的所有方法都绑定到某个人身上,而是像上面这样,用一个特殊的字段 __proto__ 来指定:我的原型是 peoplePrototype 这个对象,同时,我们还制定了一个规则:如果你想请求我的某个方法,在我自己身上没有,那就去我的原型上面找吧,如果我的原型上面没有,那就去我的原型的原型上面去找,直到某个位置,没有更上层的原型为止

像上面这样创建的 people 对象,有自己的属性,但是当我们去访问 people.speak() 方法的时候,其实访问的是 people.__proto__.speak(),这是我们的规则。

更优雅的创建新新人类

我们总不能在需要创建新人的时候,都像上面这样,自己去写一个对象,然后再手工指定它的原型是什么,所以,我们可以创建一个函数,专门用来生成人类的:

const peoplePrototype = {
    name: '',
    sex: 'unknown',
    birth: '',
    walk: function () {},
    run: function () {},
    jump: function () {},
    speak: function () {},
    coding: function () {}
}
const makePeople = function makePeople(name, sex, birth) {
  let people = {}
  people.name = name || peoplePrototype.name
  people.sex = sex || peoplePrototype.sex
  people.birth = birth || peoplePrototype.birth
  people.__proto__ = peoplePrototype
  return people
}

people = people.map(makePeople)

现在这样我们只需要引入 makePeople 这个函数就可以随时随地创建新人了。

更优雅一点的改进

显然,上面这样并不是最好的办法,定义了一个原型,又定义了一个原型对象,我们可以把这两个合并到一起,所以,就可以有下面这样的实现了:

const People = function People (name, sex, birth) {
  let people = {}
  people.name = name || People.prototype.name
  people.sex = sex || People.prototype.sex
  people.birth = birth || People.prototype.birth
  people.__proto__ = People.prototype
  return people
}

People.prototype = {
    name: '',
    sex: 'unknown',
    birth: '',
    walk: function () {},
    run: function () {},
    jump: function () {},
    speak: function () {},
    coding: function () {}
}

我们直接把创建人类的那个函数叫作 People,这个函数有一个属性叫 prototype,它表示用我这个函数创建的对象的原型是什么,这个函数做的事情还是以前那些事儿,创建临时对象,设置对象的属性,绑定一下原型,然后返回。

神奇的 this

我们除了人,还有别的动物,比如 Tiger、Fish等,按上面的方式,在 Tiger() 或者 Fish() 函数里面都会建立不同的 tiger 或者 fish 名称的临时对象,这样太麻烦,我们把这种函数创建出来的对象,都可以统一叫作“这个对象” ,也就是 this object,不在关心是人是鬼,统一把所有的临时对象都叫 thisObject 或者更简单的就叫作:这个,即 this。

const People = function People (name, sex, birth) {
  let this = {}
  this.name = name || People.prototype.name
  this.sex = sex || People.prototype.sex
  this.birth = birth || People.prototype.birth
  this.__proto__ = People.prototype
  return this
}

当然,上面的这一段代码是有问题的,只是假想一样,这样是不是可行。

new

到现在为止,我们发现了整个代码的演变,是时候引出这个 new 了,它来干什么呢?它后面接一个类似上面这种 People 的函数,表示我需要创建一个 People 的实例,它的发明就是为了解决上面这些所有重复的事情,有了 new 之后,我们不需要再每一次定义一个临时对象,在 new 的上下文关系中,会在 People 函数体内自动为创建一个临时变量 this,这个就表示即将被创建出来的对象。同时,对于使用 new 创建的实例,会自动的绑定到创建函数的 prototype 作为原型,还会自动为 People 创建一个 constructor 函数,表示这个原型的创建函数是什么,所以,我们可以改成下面这样的了:

const People = function People (name, sex, birth) {
  this.name = name || People.prototype.name
  this.sex = sex || People.prototype.sex
  this.birth = birth || People.prototype.birth
}

People.prototype.name = ''
People.prototype.sex = 'unknown'
People.prototype.birth = ''
People.prototype.walk = function () {}
People.prototype.run = function () {}
People.prototype.jump = function () {}
People.prototype.speak = function () {}
People.prototype.coding = function () {}

people = people.map(p => new People(...p))

总结

new 到底干了什么?当 new People() 的时候

  1. 创建临时变量 this,并将 this 绑定到 People 函数体里
  2. 执行 People.prototype.constructor = People
  3. 执行 this.__proto__ = People.prototype
  4. 执行 People 函数体中的自定义
  5. 返回新创建的对象

Lodash 是一个具有一致接口、模块化、高性能等特性的 JavaScript 工具库。

官网

https://lodash.com

安装

浏览器

<script src="path/to/lodash.js"></script>

AMD Loader

require(['lodash', function( _ ) {
  // do something with lodash _;
});

使用 NPM

npm i --save lodash

NodeJS/IOJS

// 加载整个模块
const _ = require('lodash');
// 或者者只加载某个分类下的所有方法(子模块)
const array = require('lodash/array');
// 或者只加载某个特定的方法
const chunk = require('lodash/array/chunk');

功能、方法介绍以及使用示例

_.chunk(array, [size=1])

将 array 拆分成多个 size 长度的块,把这些块组成一个新数组。 如果 array 无法被分割成全部等长的块,那么最后剩余的元素将组成一个块。

参数

  1. array:Array 类型,需要被处理的数组;
  2. [size=1]:Number 类型,每个块的长度。

返回值

  • Array 类型,返回一个包含拆分块数组的新数组(相当于一个二维数组)。

示例

_.chunk(['a', 'b', 'c', 'd'], 2);
// => [['a', 'b'], ['c', 'd']]

_.chunk(['a', 'b', 'c', 'd'], 3);
// => [['a', 'b', 'c'], ['d']]

创建项目

在本文中,我们将创建一个简单的用于管理自己的任务列表的应用,要创建一个新的 Meteor 项目,打开终端命令行工具,然后输入以下命令:

meteor create meteor-todos

在会在当前的工作路径下创建一个名为 meteor-todos 的文件夹,该文件夹下面将包含以下文件:

client/main.js        # 客户端加载 JS 的入口
client/main.html      # 定义视频的 HTML 文件
client/main.css       # 定义应用样式的 CSS 文件
server/main.js        # 服务器端应用的入口文件
package.json          # NPM 包管理工具使用的配置文件
.meteor               # Meteor 文件
.gitignore            # Git 配置文件

要运行该应用,执行以下命令:

cd meteor-todos
meteor npm install
meteor

执行成功之后,打开浏览器访问 http://localhost:3000即可看到新的应用,在进行下一步之前,你可以尝试修改一下 client/main.html 中 h1 标签的内容,你可以看到,当你保存文件之后,浏览器中的页面会自动的刷新。

关于设计转码,有一个更新被大家所认可的名称,叫作“切图”,在本文中我没有使用“切图”二字的原因在于,在我所理解的设计转码工作中,并不只是切图这么简单。

长久以来我们怎么做?

自从出现Web这个事物开始,每一个Web页面就会经历从产品需求到设计到出图到转码的这么一个过程,虽然技术变革给我们带来了很多炫酷的工具以帮助我们更加快速、方便的进行这样的工作,但是最终工具终归是工具,人,这一动作的主体永远都无法去掉:

  1. 产品提出需求,制作产品交互原型;
  2. 设计师根据产品的交互原型制作精美的设计图;
  3. 切图工作者将设计图转换成HTML静态页面。

上面是我们最常见的工作流程,而用到的工具最多的还是 Photoshop,对于切图工作者,用到得最多的又是 Photoshop 里面的 切片工具,它能快速的将一整张PSD图切割为很小的块,然后导出,再从导出的图片里面选取我们需要的使用即可(而在以前,很多人更是直接使用了 Photoshop 导出的HTML进行修改即直接应用到最终的产品代码中去)。

长久以来我们又有什么样的问题?

按上面这种工作流程,看似很平常不过了,也特别符合我们心理预期的工作流程,但是,却有很多问题:

  1. 交互原型在很大程度上已经给设计定型了,比如交互原型里面会指出哪里有按钮,哪里是一个列表,哪里有一个表格,哪里放一个Banner等;
  2. 设计师很多时候仅仅只是美化交互原型,比如将按钮改个配色,调整一下元素的尺寸,画一个漂亮的Banner,精细的设计师会让自己的设计图精确到一个像素,这就是我们常说的像素级精确的设计;
  3. 而切图工作者在将设计转码的过程中,为了保证还原度,很多时候也很无奈的只能使用切图工具将设计图导出为一些图片切片,然后再用代码拼接到整个页面中,硬性的将Photoshop里面的图层对应到CSS里面的Layers中,然后定位也像设计图版的像素级的去调整。

这种方式所带来的最大的问题,并不是最终成品的效果不好,而是,整个工期太长,尤其是在响应式布局以及移动设备流行之后,更是在绝大多数情况下,压根就无法满足生产的需要了。

后来大家都又想过什么样的解决办法?

说起前面这些问题的解决办法,我想最多的,还是都没有解决最终问题,因为工作流程都没有想过要去改变,还是产品-设计-转码这样的流程,那这样的流程就决定了永远都存在切图这一个工种,而解决的办法就是提升这个流程中每一个环节的工作效率,比如各种各样的在线或者线下的工具,用于将导入的PSD自动按图层、分组等导出;或者制定PSD文件的制作标准(比如图层如何分组、名称应该如何定等),但是问题依旧存在。

对于新手,可能还是先使用Photoshop切出图片,然后再一边写着HTML一边写着CSS,最后缓慢的完成一个产品,而我自己也总结了一套自己的切图方式,还算比较快速:

  1. 先浏览所有设计图,找出设计图中通用的布局与元素样式,先将这些基础的元素转为代码(此时基本上不需要切图,因为绝大多数情况下都能直接使用CSS样式化出来同样或者特别接近的效果);
  2. 使用上一步完成的基础的样式库一般都完成所有页面的布局与样式工作;
  3. 再对每一页的特殊元素进行特殊处理。

这个方式在技术上一般是下面这样的书写步骤:

  1. 先看图直接完成所有元素与布局的HTML结构;
  2. 完成HTML结构之后,再完成CSS样式;
  3. HTML中,基础元素全部使用 class 而不是ID
  4. ID 直接应用到整个Page。

关于上面所用方式的一段代码示例

<body id="page-name-id">
  <header>
    <h1>网页名称</h1>
    <nav>
      <a href="index.html" title="网站名称">首页</a>
      <a href="about.html" title="关于我们">关于</a>
    </nav>
  </header>
  <div class="columns">
    <article class="news-item">
      <h2>文章标题</h2>
      <p>内容</p>
    </article>
    <aside>
      ...
    </aside>
  </div>
</body>

而后,CSS中有可能有两份

body {...}
header {...}
article {...}
h2 { ... }
article h2 { ... }
...

然后对于某个单独的页面

#page-name-id article {...}

这上面这些工作都完成之后,就到了切图的工作了,但是与以前的切图工作不再一样的是,不再是使用切片工具将整个图都切出来,而是按需要将元素取出来,在很多,一张设计图只需要取出图标、背景、Banner等元素即可。

解决问题的一种方法

我一直都是属于那种比较偷懒的人,如果想要解决切图的问题,那最好就是压根就不存在这个问题,但是如何可以让我们的工作流程中规避掉?

某一种方法

改变现有工作的工具以及工作方式个人感觉应该是最好不过的方式了,大概的思路是:

技术结构

  1. 版本管理: Git/Gitlab
  2. 文档编写: Markdown / Office Word
  3. 交互原型与设计: Sketch / Photoshop

基本工作流程

  1. 产品人员出产品需求文档,详细描述产品功能细节;
  2. 交互设计使用Sketch制作交互原型;
  3. 设计师使用直接美化Sketch交互原型,若有需要细化设计的图片,使用Photoshop单独制作并导入Sketch文档;
  4. 前端开发人员直接按照Sketch进行开发,不需要切图流程,直接使用Sketch导出所有资源文档,设计中关于颜色、尺寸的测量等直接以Sketch中的样式标注为准即可。

1.遍历数组法

最简单的去重方法, 实现思路:新建一新数组,遍历传入数组,值不在新数组就加入该新数组中;注意点:判断值是否在数组的方法“indexOf”是ECMAScript5 方法,IE8以下不支持,需多写一些兼容低版本浏览器代码,源码如下:

// 最简单数组去重法
function unique1(array){
  var n = []; //一个新的临时数组
  //遍历当前数组
  for(var i = 0; i < array.length; i++){
    //如果当前数组的第i已经保存进了临时数组,那么跳过,
    //否则把当前项push到临时数组里面
    if (n.indexOf(array[i]) == -1) n.push(array[i]);
  }
  return n;
}
// 判断浏览器是否支持indexOf ,indexOf 为ecmaScript5新方法 IE8以下(包括IE8, IE8只支持部分ecma5)不支持
if (!Array.prototype.indexOf){
  // 新增indexOf方法
  Array.prototype.indexOf = function(item){
    var result = -1, a_item = null;
    if (this.length == 0){
      return result;
    }
    for(var i = 0, len = this.length; i < len; i++){
      a_item = this[i];
      if (a_item === item){
        result = i;
        break;
      }  
    }
    return result;
  }
}

2.对象键值对法

该方法执行的速度比其他任何方法都快, 就是占用的内存大一些;实现思路:新建一js对象以及新数组,遍历传入数组时,判断值是否为js对象的键,不是的话给对象新增该键并放入新数组。注意点: 判断是否为js对象键时,会自动对传入的键执行“toString()”,不同的键可能会被误认为一样;例如: a[1]、a["1"] 。解决上述问题还是得调用“indexOf”。

// 速度最快, 占空间最多(空间换时间)
function unique2(array){
  var n = {}, r = [], len = array.length, val, type;
    for (var i = 0; i < array.length; i++) {
        val = array[i];
        type = typeof val;
        if (!n[val]) {
            n[val] = [type];
            r.push(val);
        } else if (n[val].indexOf(type) < 0) {
            n[val].push(type);
            r.push(val);
        }
    }
    return r;
}

3.数组下标判断法

还是得调用“indexOf”性能跟方法1差不多,实现思路:如果当前数组的第i项在当前数组中第一次出现的位置不是i,那么表示第i项是重复的,忽略掉。否则存入结果数组。

function unique3(array){
  var n = [array[0]]; //结果数组
  //从第二项开始遍历
  for(var i = 1; i < array.length; i++) {
    //如果当前数组的第i项在当前数组中第一次出现的位置不是i,
    //那么表示第i项是重复的,忽略掉。否则存入结果数组
    if (array.indexOf(array[i]) == i) n.push(array[i]);
  }
  return n;
}

4.排序后相邻去除法

虽然原生数组的”sort”方法排序结果不怎么靠谱,但在不注重顺序的去重里该缺点毫无影响。实现思路:给传入数组排序,排序后相同值相邻,然后遍历时新数组只加入不与前一值重复的值。

// 将相同的值相邻,然后遍历去除重复值
function unique4(array){
  array.sort(); 
  var re=[array[0]];
  for(var i = 1; i < array.length; i++){
    if( array[i] !== re[re.length-1])
    {
      re.push(array[i]);
    }
  }
  return re;
}

5.优化遍历数组法

源自外国博文,该方法的实现代码相当酷炫;实现思路:获取没重复的最右一值放入新数组。(检测到有重复值时终止当前循环同时进入顶层循环的下一轮判断)

// 思路:获取没重复的最右一值放入新数组
function unique5(array){
  var r = [];
  for(var i = 0, l = array.length; i < l; i++) {
    for(var j = i + 1; j < l; j++)
      if (array[i] === array[j]) j = ++i;
    r.push(array[i]);
  }
  return r;
}

最近面试比较多,收集整理了一些常见的面试题,还算不错。

1.创建JavaScript对象的两种方法是什么?

这是一个非常简单的问题,如果你用过JavaScript的话。你至少得知道一种方法。但是,尽管如此,根据我的经验,也有很多自称是JavaScript程序员的人说不知道如何回答这个问题。

  • 使用 new 关键字来调用函数。
  • open/close 花括号。
var o = {};

你也可以继续提问,“使用new关键字,什么情况下创建对象?”但是,由于我只是想淘汰一些人,所以这些问题我会等到真正面试的时候去问。

2.如何创建数组?

这和“如何创建对象”是相同级别的问题。然而,也有一些人回答得了第一个问题,却不能回答这个问题。

用下面的代码,简简单单就能创建一个数组:

var myArray = new Array();

创建数组是一个很复杂的过程。但是我希望能从应聘者口中听到使用方括号的答案。

var myArray = [];

当然,我们还可以继续问其他问题,比如如何 高效地删除JavaScript数组中的重复元素 等,但是由于我们只需要知道应聘人员是否值得进一步的观察,关于数组的问题我会到此结束。

3.什么是变量提升(Variable Hoisting)?

这个问题稍微难一点,我也并不要求对方一定得回答出来。但是,通过这个问题能够快速确定应聘者的技术水平:他们是否真的像他们声明得那样理解这门编程语言?

变量提升指的是,无论是哪里的变量在一个范围内声明的,那么JavaScript引擎会将这个声明移到范围的顶部。如果在函数中间声明一个变量,例如在某一行中赋值一个变量:

function foo() {
    // 此处省略若干代码
    var a = "abc";
}

实际上会这样运行代码:

function foo() {
    var a;
    // 此处省略若干代码
    a = "abc";
}

4.全局变量有什么风险,以及如何保护代码不受干扰?

全局变量的危险之处在于其他人可以创建相同名称的变量,然后覆盖你正在使用的变量。这在任何语言中都是一个令人头疼的问题。

预防的方法也有很多。其中最常用的方法是创建一个包含其他所有变量的全局变量:

var applicationName = {};

然后,每当你需要创建一个全局变量的时候,将其附加到对象上即可。

applicationName.myVariable = "abc";

还有一种方法是将所有的代码封装到一个自动执行的函数中,这样一来,所有声明的变量都声明在该函数的范围内。

(function(){
   var a = "abc";
})();

在现实中,这两种方法你可能都会用到。

5.如何通过JavaScript对象中的成员变量迭代?

for(var prop in obj){
    // bonus points for hasOwnProperty
    if(obj.hasOwnProperty(prop)){
        // do something here
    }
}

6.什么是闭包(Closure)?

闭包允许一个函数定义在另一个外部函数的作用域内,即便作用域内的其他东西都消失了,它仍可以访问该外部函数内的变量。如果应聘者能够说明,在 for/next 循环中使用闭包却不声明变量来保存迭代变量当前值的一些风险,那就应该给对方加分。

7.请描述你经历过的JavaScript单元测试。

关于这个问题,其实我们只是想看看应聘人员是否真的做过JavaScript单元测试。这是一个开放式问题,没有特定的正确答案,不过对方至少得能讲述进程中的一些事情。

Ionic V2 与 Ionic V1 一样提供了 CLI 工具与 GUI 的工具。

安装 Ionic V2

安装 Ionic 2,可以使用下面的命令:

npm install -g ionic@beta
完全不需要担心 Ionic V1 版本的项目,Ionic@Beta 可以完全兼容 Ionic V1 的项目。

安装完成之后可以使用下面的命令创建新项目:

ionic start cutePuppyPics --v2

运行新创建的项目, cd 进入项目目录之后,运行 ionic serve 命令即可:

cd cutePuppyPics
ionic serve

执行之后,即可像 Ionic v1 一样在浏览器中查看项目了。

构建

要构建 Ionic 项目,需要先安装 cordova :

sudo npm install -g cordova

为 iOS 构建

ionic platform add ios
你需要先安装 XCode,XCode 允许你直接为 iOS 系统的目标设备构建应用。添加了 iOS 系统之后,即可使用下面的命令运行模拟器:
ionic emulate ios

为 Android 构建

ionic platform add android

接下来你还需要安装 Android SDK ,Android SDK 允许你为 Android 目录设备构建应用,虽然 Android SDK 本身就带了一个模拟器,但是更加推荐你使用 Genymotion:

ionic run android

迁移

Ionic 1.x 是基于 Angular 1.x 技术的,同样的 Ionic 2.x 基于 Angular 2.x,所以,虽然 Ionic 本身的理念没有太多改变,但是代码的写法也因为 Angular 的改变而变得很不一样,Angular 2.x 使用了完全不一样的语法与代码结构(要了解 Angular 2.x 的变化,可以查看 学习 Angular 2 这个网站。

下面这个是 Ionic 1.x 中的写法:

.config(function($stateProvider) {
  $stateProvider
  .state('main', {
    url: '/',
    templateUrl: 'templates/main.html',
    controller: 'MainController'
  })
})

.controller('MainController', function() {

})

现在在 Ionic 2.x 中可以像下面这样写:

@Page({
  templateUrl: 'main/main.html'
})

export class MainCmp {
  constructor() {

  }
}

从 Angular 1.x 迁移

ControllerAs 语法是一个 Angular 1.x 提供的功能,它可以我们不需要使用 $scope 变量即可做到数据绑定,而是将数据直接绑定至 Controller 上,在 Angular 2.x 中,ControllerAs 的实现更加简单了,对比下面是 Angular 1.x 实现:

index.html

<ion-content ng-controller="MainController">
  <ion-item>
    {{ data.text }}
  </ion-item>
</ion-content>

app.js

.controller('MainController', function($scope) {
  $scope.data = {
    text: 'hello world'
  }
})

将上面的示例改成 ControllerAs 语法只需要改变很小的一点代码:

index.html

<ion-content ng-controller="MainController as main">
  <ion-item>
    {{ data.text }}
  </ion-item>
</ion-content>

app.js

.controller('MainController', function() {
  this.data = {
    text: 'Hello World'
  }
})

TypeScript

TypeScript 是一个提供了 ES6 类 与类型注释的 JavaScript 超集 ,这使得我们可以在 Ionic 项目中按照 ES6 的标准来写。

app.js

.controller('MainController', function() {
  this.data = {
    text: 'Hello World'
  }
})

app.ts

export class MainController {
  constructor() {
    this.data = {
      text: 'Hello World'
    }
  }
}

项目结构

在 Angular 1.x 中,最好的项目实践是将所有的 JavaScript 脚本都放在一起,模板文件也放在一起,但是他们两者却是分开的,比如下面这样:

|-www/
|
|--js/
|--|-app.js
|--|-HomeController.js
|--|-DetailController.js
|
|--templates/
|--|-Home.html
|--|-Detail.html
|
|-index.html

但是在 Angular 2.x 中,推荐像下面这样的:

|-www/
|
|--Home/
|--|-HomeController.js
|--|-Home.html
|
|--Detail/
|--|-DetailController.js
|--|-Detail.html
|
|-index.html
|-app.js

七月份的下半个月,有幸做了奔驰 Smart 2015年新官网,包括手机端和PC端的宣传页,地址:

这里,为了证明这个是一个事实,我还特意的留存了两张截图:

QQ20150802-1@2x.jpg

QQ20150802-2@2x.jpg

这里只想说明这么几个问题:

  1. 这东西确实是我做了,而且是那种创意95天,开发两天,三天测试,100天的时候就要上线的;
  2. 奥美负责创意,把项目外包,结果就是,丫的居然告诉我,不合格,准备直接把代码转交给另外一个团队,意思就是这项目跟我没半毛钱关系;
  3. 这是纯粹对劳苦码农工作成果的蔑视,本人发誓,老子有生之年,再也不会跟任何外企扯上关系,即使被国人坑,至少不流外人田;
  4. 大家以后跟这两公司打交道,小心……切记

抵制奥美,从我做起

抵制奔驰,人人有责

Looking for something else? Take a look at the awesome collection of other awesome lists.

吐槽过程中随便写了点东西,可以很多地方欠周全,不过差不多吧应该。

这么久以来,我听着最恶心的就是H5这两个字符,H5是什么?它是 HTML5 ,也就是 HTML 第五版在中国的IT圈里面的一种缩写,最开始是因为淘宝,腾讯等大公司将自己的以前的 wap 与 3g 网站(也就是3G时代以前手机端的网站,使用的是简化的HTML技术)改成 h5 网站,二级域名使用的是 h5.xxx.com 这种的,人家的意思是”这是一个基于 HTML 5 技术的网站“,就像以前的这是一个基于 WAP 技术的网站是一个意思,但是,中国的IT人总是会创出很多”有意思“的行话来,比如,H5,但是,那我们暂且认同这种说法吧,暂且把 H5 定义为 HTML5 的简称,那我们来看看 HTML5 是什么?

HTML5是HTML最新的修订版本,2014年10月由万维网联盟(W3C)完成标准制定。目标是取代1999年所制定的HTML 4.01和XHTML 1.0标准,以期能在互联网应用迅速发展的时候,使网络标准达到符合当代的网络需求。广义论及HTML5时,实际指的是包括HTML、CSS和JavaScript在内的一套技术组合。它希望能够减少网页浏览器对于需要插件的丰富性网络应用服务(Plug-in-Based Rich Internet Application,RIA),例如:Adobe Flash、Microsoft Silverlight与Oracle JavaFX的需求,并且提供更多能有效加强网络应用的标准集。

具体来说,HTML5添加了许多新的语法特征,其中包括 <video>、<audio>和<canvas>元素,同时集成了SVG内容。这些元素是为了更容易的在网页中添加和处理多媒体和图片内容而添加的。其它新的元素如<section>、<article>、<header>和<nav>则是为了丰富文档的数据内容。新的属性的添加也是为了同样的目的。同时也有一些属性和元素被移除掉了。一些元素,像<a>、<cite>和<menu>被修改,重新定义或标准化了。同时APIs和DOM已经成为HTML5中的基础部分了。HTML5还定义了处理非法文档的具体细节,使得所有浏览器和客户端程序能够一致地处理语法错误。

上面这两段是引用自维基百科的解释,其实说白了,HTML5就是提供了更多特性的 HTML。那我们再来看 HTML 是什么,还是引用维基百科的解释:

超文本标记语言(英文:HyperText Markup Language,HTML)是为“网页创建和其它可在网页浏览器中看到的信息”设计的一种标记语言。HTML被用来结构化信息——例如标题、段落和列表等等,也可用来在一定程度上描述文档的外观和语义。1982年由蒂姆·伯纳斯-李创建,由IETF用简化的SGML(标准通用标记语言)语法进行进一步发展的HTML,后来成为国际标准,由万维网联盟(W3C)维护。 HTML档案最常用的扩展名(扩展名)为.html,但是有如DOS等的旧操作系统限制扩展名最多为3个文字符号,所以.htm扩展名也允许使用。而如今.htm扩展名的使用较为减少。

编者可以使用任何基本的文本编辑器(例如Notepad等)或所见即所得的HTML编辑器来编辑HTML文件。 早期的HTML语法规则定义较为松散,这有助于不熟悉网络出版的人使用或变更。网页浏览器接受这类的文件,使之可以显示语法不严格的网页。随着时间的流逝,官方标准渐渐趋于严格的语法,但是浏览器继续显示一些仍不合乎标准的HTML。使用XML的严格规则的XHTML(可扩展超文本标记语言)是W3C计划中的HTML的接替者。虽然很多人认为它已经成为当前的HTML标准,但是它实际上是一个独立的、和HTML平行发展的标准。W3C目前建议使用XHTML 1.1、XHTML 1.0或者HTML 4.01标准编写网页,但已有许多网页转用较新的HTML5编码撰写(如Google)。

不知道说到这里各位理解HTML5和HTML了没,如果没有理解,可以想想下面这种场景:

XX写一篇文章,发布到网站上面去,文章嘛,有标题,有摘要,有段落,有列表,还有可能有插图,但是这个该怎么写呢?我得让浏览器知道哪些是标题,哪些又是段落,哪些又是列表嘛,怎么办?这个时候可以先告诉浏览器,我用HTML标准来写文章吧,你就按HTML的标准来理解我给你的数据就可以了,所以,大家可以看到,任何一个网页的源代码的第一行都是声明,我这是一个HTML文档,而且,还申明到了,我这个文档用的是什么版本的HTML,比如,我们以前用得最多的:

<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd">

上面这一行告诉我们,我这个文档是HTML文档,遵守的是 XHTML 1.0 版本的协议,而且不需要很严格的执行这个标准备(Transitional说明的),若你(指的是浏览器)不知道我这个版本的HTML的协议(就是规范)是什么样儿的时候,你可以下载http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd这个文件,这个文件会告诉你,我的具体规范是什么。

而当我们用HTML5之后,改变的第一个就是上面这一行,我们不再需要按上面这样写了,就按下面这样写就可以了:

<!DOCTYPE html>

简单吧,就告诉你,我是HTML文档,对于低版本的浏览器,他们会选择一个自己支持的最新的HTML规范去解释这份文档,而对于支持HTML5标准的浏览器,就会直接按HTML5规范来解释了。

然后,不是有一个标题嘛,标题在HTML里面共分为六级,就是 h1,h2,h3,h4,h5,h6,看到没?h5,这个在HTML里面表示的是第五级标题,而如果你在HTML里面没有出现 H1,h2,h3,h4 的话,是不允许直接出现 h5 的,若就只是一篇文章,我们就应该直接使用 h1,所以,吐槽杂志这四个字在HTML里面是这样的:<h1>吐槽杂志</h1>,然后就是段落了,那是 p 干的活,表示,被我包着的文本是一个段落,比如:<p>我是一个段落</p>,同样的,列表有 ul ,即 unordered list,意思为无顺序的列表,ol,即 ordered list,意思是有顺序的列表,比如下面这样的一个示例,要做黄焖鸡要有几步?看下面这几步:

<ol>
    <li>杀鸡</li>
    <li>开火</li>
    <li>焖煮</li>
</ol>

上面这五行,浏览器看到之后,就会知道了,哦,这是一个有序列表,那有序列表该这么显示(说一下,li 不读李,而是 list item,即列表项):

1. 杀鸡
2. 开火
3. 焖煮

看到没,HTML里面其实就是通过各种各样的标签来标记不同意义的内容而已,到现在为止,我还只是说到了 HTML,CSS和JS都还没有涉及,如果没有CSS和JS,HTML的网页在浏览器里面看起像下面这样的:

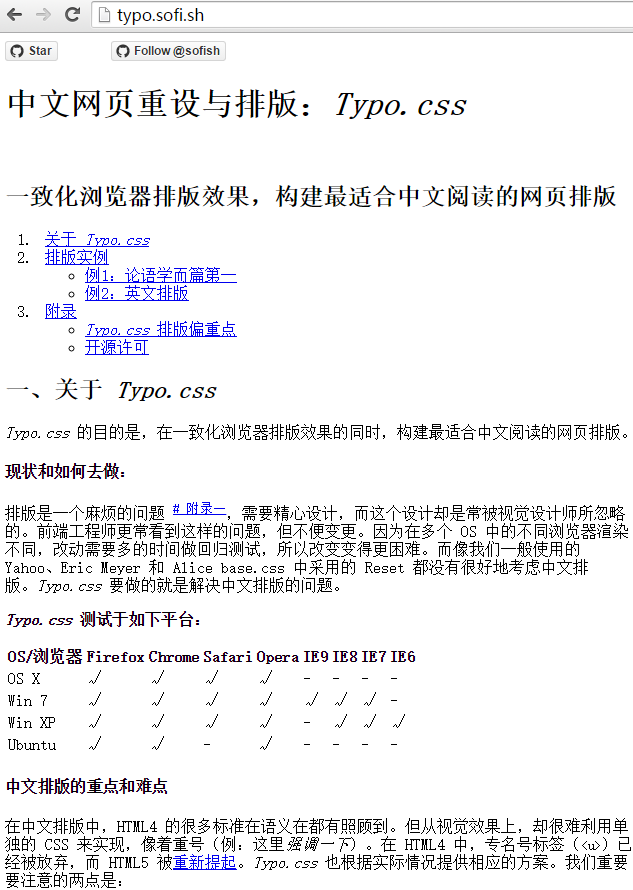
4693194F-B64E-49A8-94BE-D0B0359BFAC0.png

是不是很丑,其实这个就是HTML在浏览器里面的表现,而为什么有的字体大一点,有的黑一点,有在粗一点,那是因为浏览器通过对HTML结构的解析,然后知道不同的文本都表示的不同的意义的,比如最上面的”中文网页重设与排版:Typo.css“这一段,它是 h1 标签,一级标题,也就是一个网页里面权重最高的文本,所以,它认为应该字体大一点,粗一点,颜色深一点,我们把同样的一份没有CSS和JS的HTML文档放在不同的浏览器里面打开,显示的效果也是不一定一样的,这是因为,我认为 20号字体最能表示 h1,但是可以你却认为24号才行,但是大家基本上的理解也都还差不多,但是虽然差不多,也还是有差异,这个差异,就是所谓的浏览器兼容性(仅仅只是HTML层的,相应的CSS与JS也有兼容性问题),对同样的事物的理解不一样,才是导致兼容性存在的根本原因,但是,兼容性没关系,也都是有解决办法的。

然后,随着互联网的发展,越来越多的人感觉,我们是不是可以让网页文档(HTML文档)更加漂亮一点,这个时候,有一些NB的人就走到了一起,想到了CSS:

层叠样式表(英语:Cascading Style Sheets,简写CSS),又称串样式列表、级联样式表、串接样式表、层叠样式表、階層式樣式表,一种用来为结构化文档(如HTML文档或XML应用)添加样式(字体、间距和颜色等)的计算机语言,由W3C定义和维护。目前最新版本是CSS2.1,为W3C的推荐标准。CSS3现在已被大部分现代浏览器支持,而下一版的CSS4仍在开发过程中。

根据上面的这个解释,应该明白了吧,HTML太丑了,那我就用CSS来样式化他,你把我现在不管你认为H1 应该是多大的字体,反正我告诉你了,我这个文档,H1必须显示成 30号字体,你把你们自己的想法都别体现出来,听我的就成了,我就是想让我的读者看到 30 号字体大号的标题,那我们怎么做了,只要下面这样斥可以了:

h1 {
    font-size: 30pt;
}

这个时候,浏览器就会拿我定义的规则覆盖他们各自自己的规则了,最后字体显示成了 30号字体,同样的,除了字体大小,CSS还提供了很多很多的选择器(用来指定哪一个HTML元素的),用来定义几乎所有的HTML元素,还提供了很多的关于样式的描述,比如 颜色:color,字体:font-family,背景色:background-color等等,通过CSS,让我们可以把一份特别特别丑陋的HTML文档变得更加美观,也正是这个时候,才出现的一个新的工种,网页设计师,因为只有在存在一种技术美化网页的时候,网页设计师才能把自己的想法变成现实,这个时候,那一群工作在网站技术一线的人就分为了网页美工(对网页进行简单的设计和把设计转成HTML+CSS)和后台程序两种,记着,这个时候还没有称之为前端,而我有幸,正好是从那个时代就接触了互联网(04年了解,05年入行)。那是 Web 1.0 时代,再发展,网民越来越多,想法也越来越多,他们不再只是想着看,还想着,我看了之后是不是可以告诉你我的读后的感受?我是不是可以参与到你的话题里面去?慢慢地,这种想法被大家都认同之后,可以让访问者留言的网站出现了,这个时候,网站与读者间有了简单的交互,我写了一篇《怎么做黄焖鸡》的文章,然后有一个读者不认同我的这种做法,就可以在文章最下面的留言框里面写上自己的想法,然后点击提交,然后,他说的话,别的读者也可以看得到,然后别的读者可能又有别的想法,他们也同样可以接着在下面写上自己的想法,这个时候,BBS、博客们就出现了(我这里所说的只是网页上的BBS,其实BBS出现得更早,只是不是以网页的形式出现而已),再接着往下发展,就只是发发评论还是不行啊,那么网站主们为了方便访问者更好的参与交流中来,就想出了各种各样的方法,而最简单的方法就是让死气沉沉的网页动起来,那么,引出了JavaScript了:

JavaScript,一种直译式脚本语言,是一种动态类型、弱类型、基于原型的语言,内置支持类。它的解释器被称为JavaScript引擎,为浏览器的一部分,广泛用于客户端的脚本语言,最早是在HTML网页上使用,用来给HTML网页增加动态功能。然而现在JavaScript也可被用于网络服务器,如Node.js。在1995年时,由网景公司的布兰登·艾克,在网景导航者浏览器上首次设计实现而成。因为网景公司与昇阳公司合作,网景公司管理层次结构希望它外观看起来像Java,因此取名为JavaScript。但实际上它的语义与Self及Scheme较为接近[4]。为了获取技术优势,微软推出了JScript,与JavaScript同样可在浏览器上运行。为了统一规格,1997年,在ECMA(欧洲计算机制造商协会)的协调下,由网景、昇阳、微软和Borland公司组成的工作组确定统一标准:ECMA-262。因为JavaScript兼容于ECMA标准,因此也称为ECMAScript[5]。

上面的定义可能有一些拗口,简单来说,JavaScript可以在浏览器里面运行,运行之后可以产生各种各样的动作,比如让一个标题从左向右走着跑马灯,而不再是定在那里不动等等,这个时候的网页越来越有趣味,以前可能就是在文章的最下面有一个评论框,但是现在却不一样了,文章最下面就一个“点我打开评论框”,然后用户点一下,就在网页里面弹出一个对话框来,用户可以在对话框里面输入内容,然后点击确定,就添加好评论了,这样一来,网页的读者参与感越来越强,再往后发展,才产生一个新的工种 ,用户体验设计师,他们是一群研究与提升读者在你的网页里面的感受的,再往后发展为交互体验设计师(就是我们Ocean的工种),但是交互体验只是在想各种各样的办法和理论来告诉你,怎么做更好,但是他们本身却并不会做,比如,Ocean告诉你:当网页往下翻到第500像素的位置的时候,叮当猫从网页的左边跳出来,然后出来一个气泡,里面一个一个字的出现一句话:大家好,我叫呆小当。

那么,什么人去把这种想法付诸实现呢?前端,那我们应该知道前端干的活儿了吧,前端就是把前端设计师、交互设计师的各种各样的想法变成实际的实现的人,那前端具体要怎么实现上面的那个想法呢?下面这样的:

写一个JS程序,这个JS程序要监听这么几件事情:a) 网页现在在什么位置? b) 若滑动到 500 的话,让叮当猫从左边跳出来,然后出来一个气泡……

但是JS要怎么实现这些动效?它用到了CSS,前面说过CSS是用来样式化HTML文档的,怎么用?先用CSS把叮当猫在网页里面隐藏,比如下面这样的:

.doraemon-cat {
    display: none
}

这个表示,.doraemoney-cat 这个名字的图片,它的展示方式(display)为 不显示(none,即什么也没有)

然后当网页滑动到 500 px 的时候, js 通过 css 把这个图片的 display 属改成 block(以以块显示)

然后再控制其它的如文字出来哪之类的。

知道没,前端需要的技能是HTML+CSS+JavaScript这三种技术的完美配合才能达到最佳效果的,所以,当大家尤其是某某自己在说自己是做前端的的时候,我就只有在心里呵呵一声了,而这个也正是我本来来这里应该做的事情,将交互设计师的创业与想法通过HTML+CSS+JavaScript变成实现。一个不会JS,一个不会CSS,三条腿能稳当,少一条怎么可能站得起来?即使站起来了,随便小风小浪一吹一打就倒了,这也就是为什么我们现在的整个前端架构为什么这么脆弱的原因了。

那么,我们为什么前端又有兼容性呢?其实原因还是因为浏览器对同样的东西的理解不一样导致的,比如,js 里面 alert 这个东西,在 IOS 的浏览器里面显示成半透明的白色,而Android可以显示成半透明的黑色,这就是兼容性,但是并没有谁对谁错,只是理解不一样而已,但是,但是,又但是,对各种不同环境下对同样的东西作出不一样的解释这种现象,说成无法解决的问题,我就只能哈哈一下了。

有兼容性本身并不可怕,我们可以尽可能的少用那些有兼容性问题的特性,或者我们可以很明确的为不同的浏览环境做不同的处理,但是,一般情况下,都不可能出现,IOS 有,Android却没有的特性,也就是说,不管是什么功能,只要是HTML有的特性,那么浏览器里面一般都会有,只要是CSS里面有的特性,各种不同的浏览器里面也一般都会有,JS也一样,只是解释不太一样,我们在完成一个作品(我叫完成一个作品,而不是完全一个任务)的时候,用一个很简单的规避方式就能避免这些问题,但是,现在我们有的人的做法是,自己不知道这里面的异同,然后以自己浅薄的那一点点知识来告诉更加不懂的人:这就是这样的,没有办法,技术是实现不了的,就有点儿让人接受不了了,这让我想起去年,我在学习一个叫作 Ionic 的新技术的时候,在Android里面,导航条就是跑在屏幕的最上面,而在 iOS 的时候,就是我想要的,导航条在下面,我当时在网上各种圈子里面各种吐槽,说一个这么成熟的框架居然还有这种Bug,犯这种SB错误,然而,某一天,当我很仔细的翻看了人家官方的文档之后,我瞬间就想往地缝里钻,人家说得很明白,系统在 Android 环境下,默认导航条在上面,iOS 下,默认导航条在下面,若要在修改默认设置,只需要设置:

navigator.position = "bottom"或者 "top" 即可,

而我现在对于某些人的想法就是这样的,………………